Ich habe eine KI ein kleines Werkzeug allein bauen lassen. Das ist dabei herausgekommen.
Auch auf Englisch verfügbar: I let an AI agent build a small tool on its own. Here is what it could and could not do..
Alle reden gerade davon, KI-Agenten selbstständig in einer Schleife arbeiten zu lassen, bis ein Ziel erreicht ist. Das Versprechen klingt nach Vollautomatik. Mich hat interessiert, was das in der Praxis wirklich heißt. Also habe ich es ausprobiert. Ein autonomer Agent sollte ein kleines, echt nützliches Werkzeug von Anfang bis Ende bauen, und ich habe genau beobachtet, wo die Schleife die Arbeit trägt und wo trotzdem ein Mensch die Richtung vorgeben muss.
Das Werkzeug. Es heißt dotenv-guard und prüft die .env-Datei eines Projekts, also die Datei mit Konfiguration und Zugangsdaten, gegen ein Schema, das man selbst festlegt. Es meldet, was fehlt, falsch oder riskant ist, bevor die Anwendung in Produktion umkippt. Klein, aber genau die Sorte Ding, die jedes Team braucht. Es ist Open Source: github.com/achildrenmile/dotenv-guard.
Der Agent. Gebaut hat es zeroshot, ein quelloffenes System von The Open Engine, das mehrere KI-Agenten zusammenspannt. Einer plant, einer schreibt den Code, und unabhängige Prüfer kontrollieren das Ergebnis, in einer Schleife, bis die Arbeit bestätigt oder abgelehnt ist: github.com/the-open-engine/zeroshot. Auf zeroshot bin ich durch Eivind Meyer von The Open Engine gekommen, der es in einer Diskussion über autonome Agenten-Loops ins Spiel gebracht hat. Das hier ist der Praxistest, zu dem mich dieser Austausch gebracht hat. Voller Respekt an das Team dahinter. Was folgt, ist keine Rezension von zeroshot, sondern ein Blick darauf, was so eine Schleife entscheiden kann und was nicht, mit zeroshot als gut gebautem Beispiel.
Ich habe dem Agenten drei Aufgaben gegeben, jede als Issue mit klaren Kriterien. Jede hat etwas anderes gezeigt.
Aufgabe eins: ein klares Ziel, und eine Ablehnung, die ich nicht erwartet hatte
Die erste Aufgabe war der Kern. Schema lesen, .env lesen, jeden Wert nach Typ prüfen. Das ist der einfache Fall, weil sich hier prüfen lässt, was „korrekt” heißt. Ein Port liegt im gültigen Bereich oder nicht. Eine URL ist gültig oder nicht.
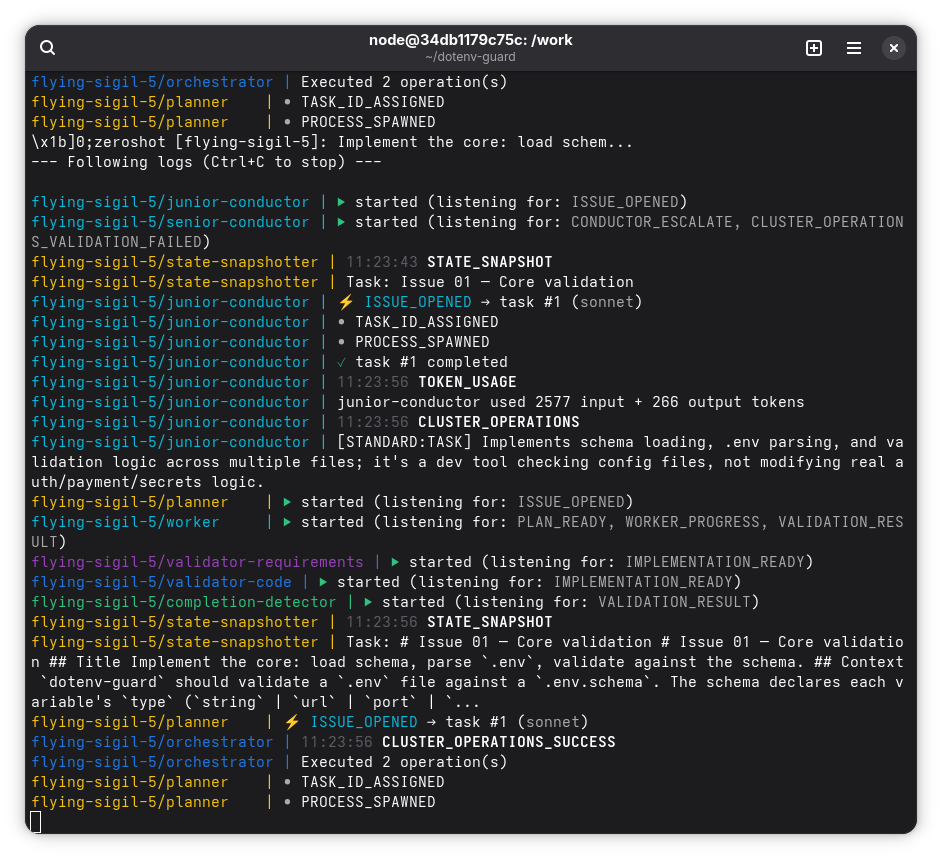 Der Agent bewertet die Aufgabe selbst: STANDARD, ein Dev-Tool, das Config-Dateien prüft.
Diese Einstufung ist erwähnenswert. Vor jeder Arbeit bewertet zeroshot das Risiko der Aufgabe. Diese hier nannte es STANDARD, mit der Begründung, es sei ein Dev-Tool, das Config-Dateien prüft und keine echte Anmelde-, Zahlungs- oder Secrets-Logik verändert. Dieses Urteil kommt später zurück.
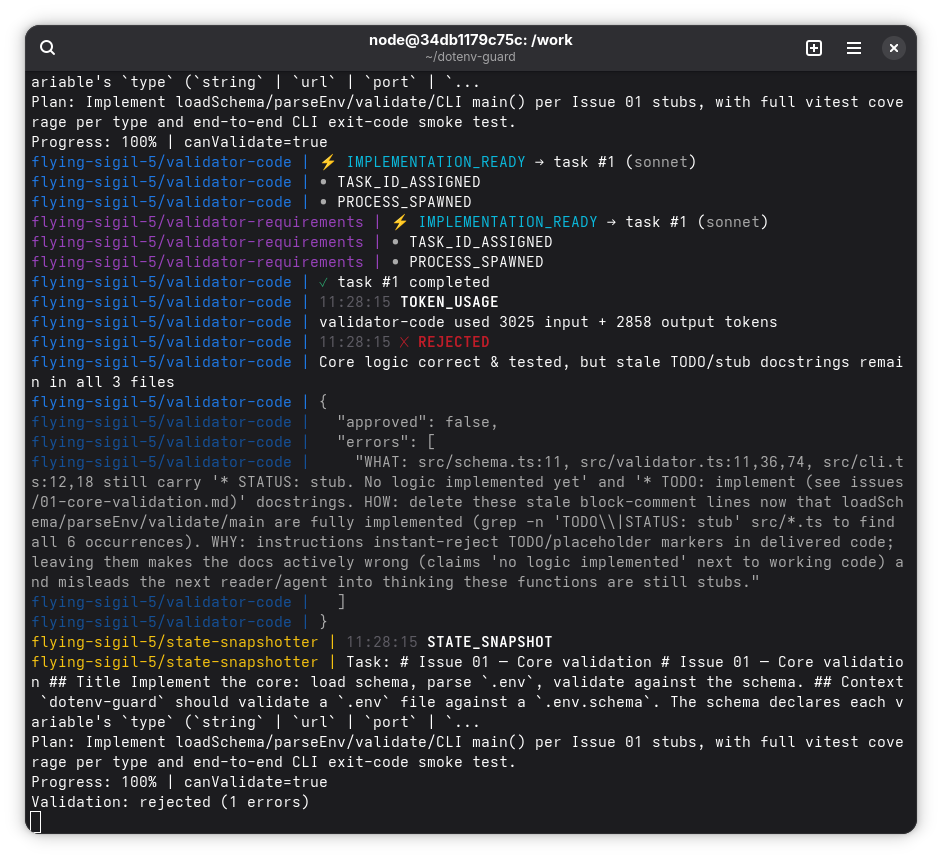
Ich hatte einen sauberen Durchlauf erwartet. Es kam anders. Der Code-Prüfer hat den ersten Versuch abgelehnt.
Der unabhängige Prüfer lehnt funktionierenden Code ab, weil die Doku noch behauptet, die Funktionen seien leere Platzhalter.
Der Code funktionierte, die Tests liefen grün, aber der Prüfer verweigerte die Freigabe. Der schreibende Agent hatte alte „TODO: implement”-Kommentare in den Dateien stehen lassen. Die Begründung des Prüfers: Diese Zeilen machen die Dokumentation aktiv falsch und führen den nächsten Leser in die Irre, der Code sei noch unfertig. Ein einzelner Agent, der seine eigene Arbeit benotet, hätte das durchgewunken. Ein unabhängiger Prüfer hat es gefangen. Dieser eine Reject ist der wichtigste Moment des ganzen Experiments. Nach der Korrektur lief es durch. Elf Tests.
Aufgabe zwei: ein vages Ziel, und wer entscheidet, was „gut” heißt
Die zweite Aufgabe war bewusst unscharf. „Mach die Fehlerausgabe benutzerfreundlicher.” Dafür gibt es keinen Test. Es gibt keine eine richtige Antwort.
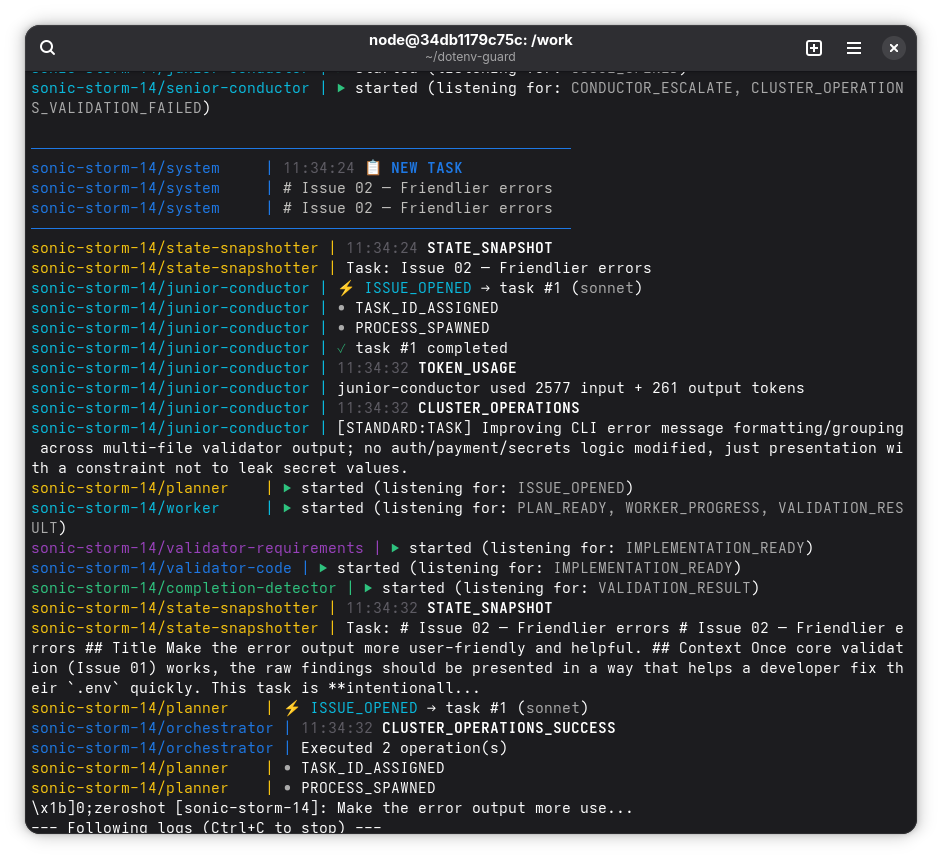 Ohne vorgegebenes Kriterium erfindet der Agent seine eigene Definition von benutzerfreundlich.
Also tat der Agent das Einzige, was er konnte. Er erfand sich eine eigene Definition. Er entschied, benutzerfreundlich heiße sortierte und gruppierte Ausgabe, an das Terminal angepasste Formatierung, und eine Warnung, wenn ein Secret noch wie ein Platzhalter aussieht. Dann prüften seine Prüfer das Ergebnis gegen diese selbstgesetzte Definition und gaben es frei. Dreiundzwanzig Tests.
Und jetzt der ehrliche Teil. Das Ergebnis war tatsächlich gut. Fehler und Warnungen getrennt, jede Meldung nennt Variable und Problem, ein wirklich hilfreicher Hinweis, das Secret vor dem Deploy zu ersetzen. Ich habe es von Hand ausprobiert, um es selbst zu sehen, und ich hätte es so ausgeliefert.
Aber achten Sie darauf, was hier passiert ist. Der Agent hat nicht beurteilt, ob die Ausgabe benutzerfreundlich ist. Er hat beurteilt, ob die Ausgabe der Definition entspricht, die er sich selbst geschrieben hat. Hätte er entschieden, benutzerfreundlich heiße „Emojis hinzufügen” oder „kürzer machen”, wäre es genauso grün durchgelaufen, mit schlechterem Ergebnis. Der einzige echte Beleg, dass es gut war, war mein Blick darauf. Ein Mensch hat den Maßstab gesetzt, im Nachhinein. Die Schleife kann das nicht.
Aufgabe drei: eine Regel, die nie brechen darf, und zwei Prüfungen, beide von Menschen gesetzt
Die dritte Aufgabe war eine Sicherheitsregel. Gib niemals den Wert eines Secrets aus. Nicht in Erfolgsmeldungen, nicht in Fehlern, nicht in Logs. Der Variablenname ist in Ordnung, der Wert muss immer maskiert sein.
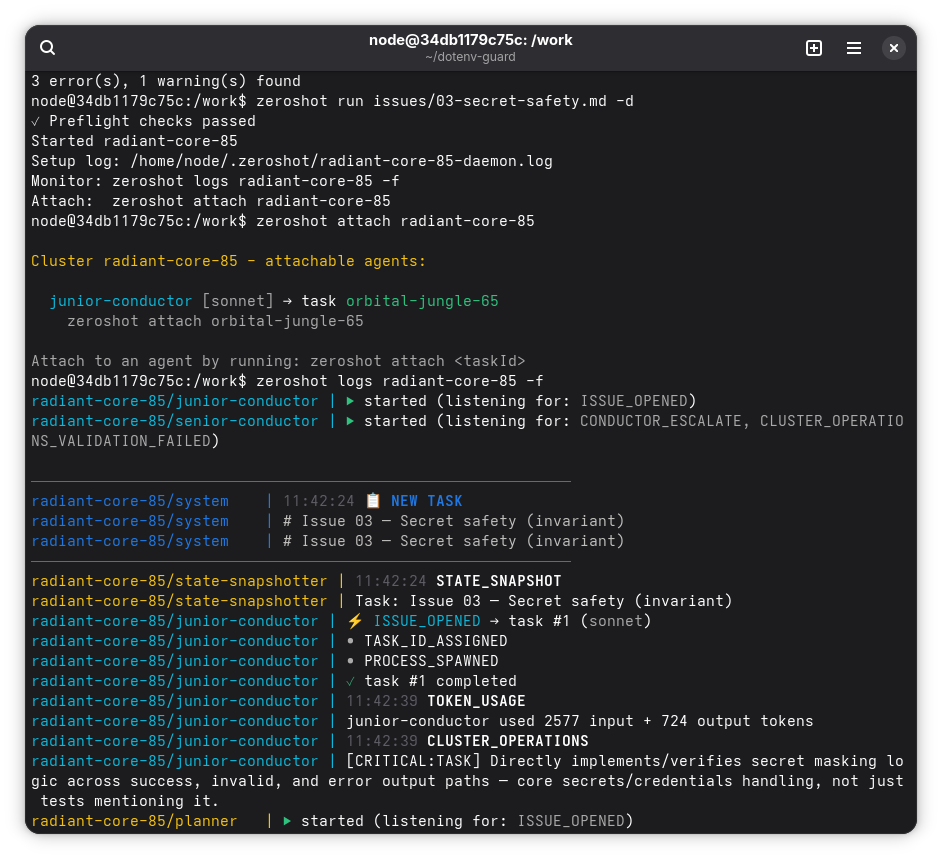 Derselbe Einstufer bewertet diese Aufgabe nun als CRITICAL, weil es um die Kern-Handhabung von Secrets geht.
Diesmal reagierte der Einstufer anders. Er bewertete die Aufgabe als CRITICAL, weil sie direkt die Masking-Logik für Secrets umsetzt und prüft, also die Kern-Handhabung von Secrets und Zugangsdaten. Dieselbe Maschine, dasselbe Werkzeug, eine völlig andere Einstufung als bei Aufgabe eins, und die richtige. Diese Höherstufung war wichtig, denn CRITICAL schaltet einen zusätzlichen Prüfer ein, eine Sicherheitsprüfung, die Aufgabe eins nie bekommen hat.
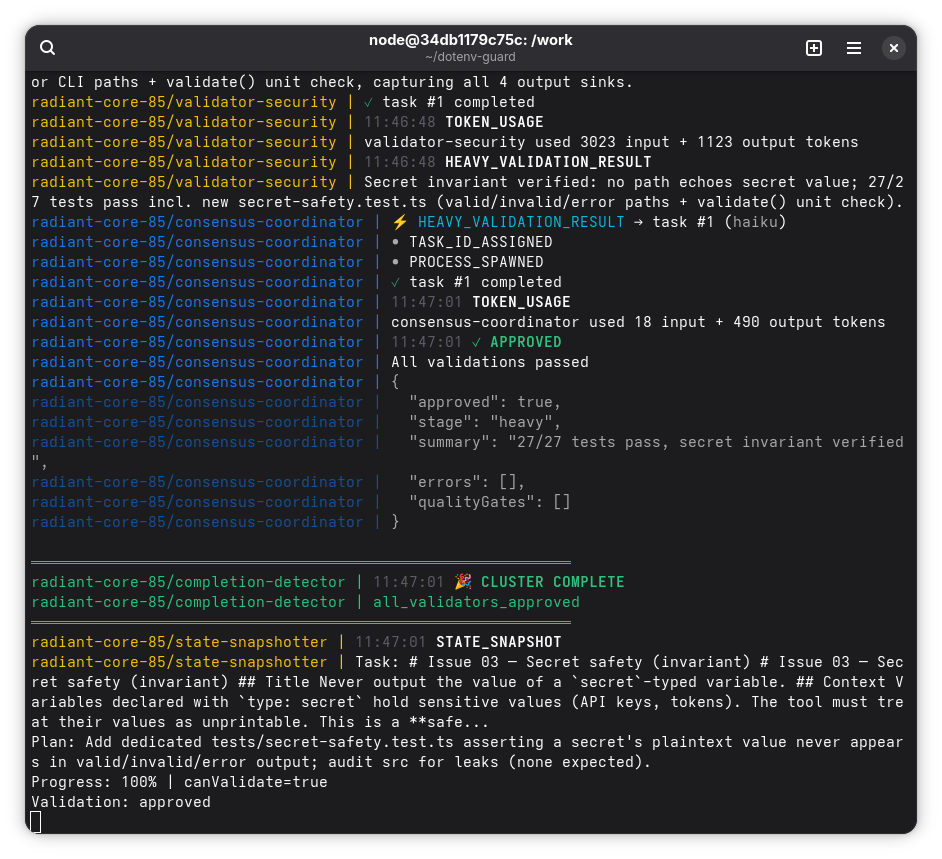 Der Sicherheitsprüfer bestätigt die Regel unabhängig. Kein Ausgabepfad verrät ein Secret.
Dieser Sicherheitsprüfer bestätigte die Regel von sich aus. Kein Pfad gibt den Secret-Wert aus, 27 von 27 Tests bestehen. Die Regel wurde also von zwei unabhängigen Prüfungen gefangen, dem Sicherheitsprüfer und dem ausdrücklichen Kriterium, das ich in die Aufgabe geschrieben hatte.
Und das ist der Punkt, der den ganzen Hype übersteht. Beide Prüfungen existieren, weil ein Mensch sie definiert hat. Jemand hat die Regel geschrieben, dass die Handhabung von Secrets als CRITICAL gilt. Ich habe das Akzeptanzkriterium geschrieben. Kein Agent hat von sich aus entschieden, dass Secrets zählen. Er hat es aus zwei von Menschen geschriebenen Regeln geerbt. Wo ich keine Regel geschrieben hatte, in Aufgabe zwei, erfand er sich eine. Wo eine Regel existierte, in Aufgabe drei, setzte er sie gut durch.
Trotzdem habe ich es selbst geprüft, denn ein grünes Häkchen ist eine Behauptung, kein Beweis.
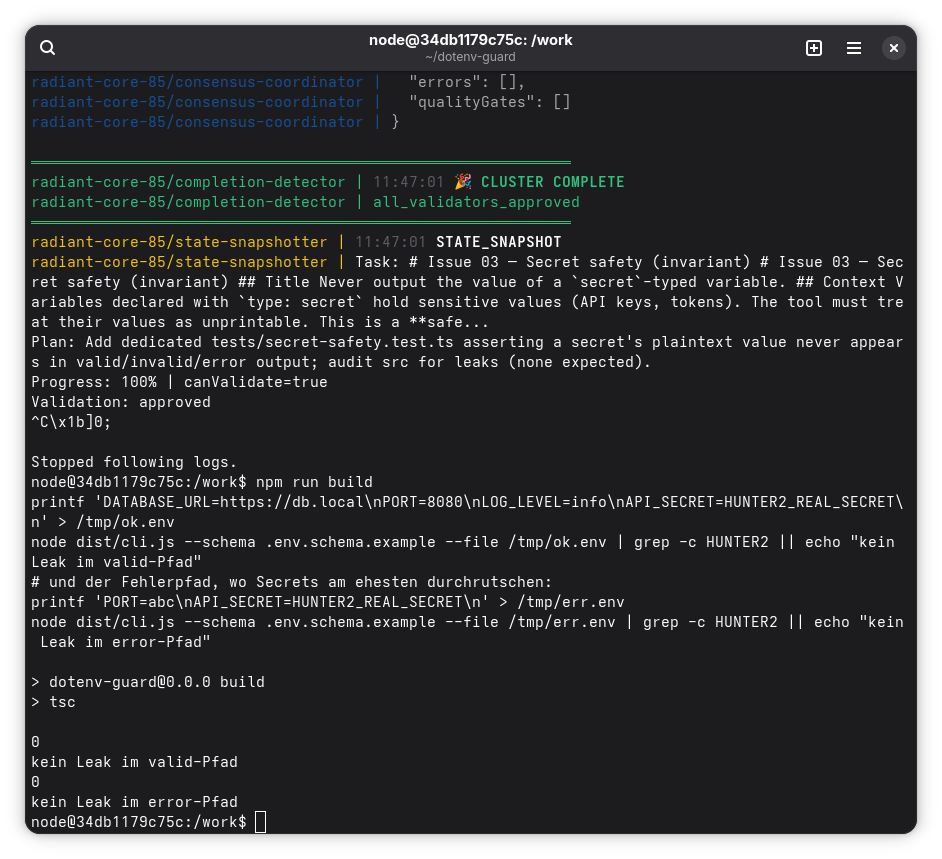 Mein eigener Gegencheck. Der Secret-Wert taucht in keiner Ausgabe auf.
Eine Zeile, die jede Ausgabe nach dem echten Secret-Wert durchsucht. Null Treffer. Der Bericht der Schleife hat gehalten.
Was drei Läufe wirklich gezeigt haben
Zusammen erzählen die drei Läufe eine klare Geschichte, und es ist nicht die Geschichte, dass die KI das Engineering übernimmt. Aber ich will ehrlich sein, auch gegen meinen eigenen Punkt: Die Schleife hat fast die gesamte Arbeit gemacht, und sie hat sie gut gemacht. Geplant, geschrieben, den eigenen Fehler gefangen, getestet, iteriert bis grün. Mein Anteil war dem Umfang nach winzig, drei kurze Aufgaben und ein prüfender Blick. Wer das beobachtet, denkt zu Recht erst einmal: Die hat das doch selbst gelöst.
Und trotzdem stimmt genau das nicht ganz. Die Schleife hat jedes Problem gelöst, das sauber gestellt war. Stellen konnte sie keines. Da, wo ich das Problem bewusst offen ließ, bei Aufgabe zwei, hat sie es nicht gelöst, sondern heimlich durch ihre eigene Definition ersetzt und die abgearbeitet. Ob diese Definition taugte, konnte sie an keiner Stelle beurteilen. Das konnten nur meine Augen. „Fast alles gebaut” und „hätte ohne mich laufen können” sind zwei verschiedene Sätze. Der erste stimmt. Der zweite nicht.
Ist das Ziel prüfbar, ist die Schleife hervorragend. Sie hat sogar einen Fehler gefangen, den ein einzelner Agent übersehen hätte. Ist das Ziel vage, erfindet sie sich ihren eigenen Maßstab, und ob der etwas taugt, kann nur ein Mensch beurteilen. Muss eine Regel halten, setzt sie sie gut durch, aber nur, weil ein Mensch die Regel überhaupt erst definiert hat. Gewählt hat sie keine davon.
Die Testzahl wuchs über die Läufe von 11 auf 23 auf 27. Das Werkzeug funktioniert, es ist echt nützlich, und ein autonomer Agent hat fast alles davon gebaut. Der Wert wanderte trotzdem nicht in die Schleife. Er blieb eine Ebene höher, in der Entscheidung, was gebaut wird, in der Wahl, was korrekt heißt, im Erkennen, wann der Agent sich nur selbst benotet, und im Urteil, ob das Ergebnis wirklich taugt. Diese Rolle ist kleiner im Umfang und größer im Gewicht, und sie fühlt sich erst einmal nach weniger an, obwohl sie mehr wiegt.
Für jeden, der abwägt, ob er echte Arbeit an KI-Agenten übergibt, ist das der Teil, der nicht verschwindet. Die Schleife ist der billige Teil. Zu entscheiden, was gebaut wird, und zu prüfen, ob es wirklich taugt, bleibt die eigentliche Aufgabe.
dotenv-guard ist offen und dokumentiert diese Läufe samt der verwendeten Umgebung, sodass sie jeder nachstellen kann: github.com/achildrenmile/dotenv-guard. Nochmals Dank an das zeroshot-Team, das etwas gebaut hat, das solide genug ist, um genau das daran zu testen.
Transparenz: Dieser Beitrag entstand mit KI-Unterstützung. Ich habe ihn geprüft und verantworte den Inhalt. Mehr dazu unter KI-Transparenz.